【环球网科技综合报道】GPU算力二十年间增长近6万倍,显存带宽与容量的增长却几乎线性——当算力芯片的演进速度远远甩开存储系统,昂贵的GPU究竟有多少时间在真正计算,又有多少时间在等待数据?
内存墙困局与第三条路:以存强算的战略逻辑
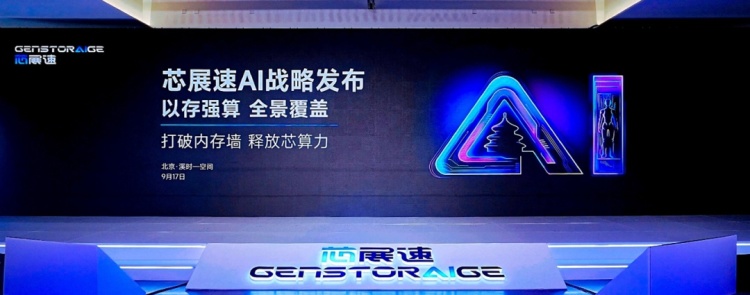
9月17日,芯展速AI战略发布会上,董事长兼CEO孙丹向在场观众提出,过去二十年GPU算力增长近6万倍,而显存带宽与容量的增长却几乎线性,“内存墙”之下,主流解法似乎只剩下KV Cache精度压缩、显存堆叠下。这一判断直指当前AI基础设施的核心矛盾:当计算单元的性能提升以数量级计,数据供给端却以线性速度跟进,两者之间的剪刀差正在不断扩大。
 芯展速合伙人兼COO钱亚欧
在会后的采访中则进一步阐释了这一矛盾的结构性根源:AI负载彻底改变了I/O模式,GPU算力二十年提升了几个数量级,显存容量增长远跟不上,显存墙让昂贵算力的有效利用率只有三四成;与此同时,智能体时代到来,数据7×24小时永不眠地产生和被消费,存储正从配角变成刚需。在这样的背景下,单纯堆叠算力已无法解决问题,必须重新审视存储在AI架构中的角色。
“以存强算,全景覆盖。”孙丹在发布会上概括了芯展速的战略方向——构建云、边、端三级数据基座:云端AI SSD提升集群整体吞吐与稳定性,边缘Token工厂与实时推理,端侧本地化AI能力。这一战略并非对算力路线的否定,而是在算力之外开辟一条协同路径:通过让存储更深地参与计算流程,缓解数据供给瓶颈,从而提升已有算力的有效利用率。
而钱亚欧将芯展速的定位表述为“不去做更贵的GPU,去做更聪明的存储”。其抓手是“存、连、管”三位一体的SCS布局:存,是企业级和AI SSD;连,是Retimer、Redriver等保障高速链路信号完整性的芯片;管,是AI训推一体的解决方案。这一布局的差异化在于,芯展速是国内少数同时具备存储与连接能力的厂商。
云边端三层落地:从全介质存储到Token工厂再到Agent PC
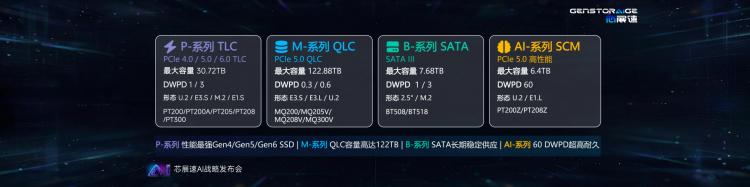
战略落地的第一站在云端。发布会上,芯展速副总裁李蓁与VAST Data中国区售前总监刘陈泓共同发布了面向云端AI存储的全介质栈方案。李蓁介绍,AI存储演进的一个重要方向是走向无分层的统一数据平台,让上层应用看到一套统一的系统、统一的数据,而不是多个割裂的层级。这一方案采用SCM加高密度QLC加高性能TLC的组合,已获得VAST Data官方认证。刘陈泓在分享中表示,芯展速PT200Z AI SSD的超高耐久与MQ系列的122.88TB超大容量,正是为“架构之上无分层”的云存储需求而生。
如果说云端解决的是海量数据的统一存放与高效访问,边侧则瞄准推理效率的突破。芯展速副总裁许玮与高级总监杨泽宏携AI90训推加速引擎亮相。许玮介绍,AI90通过智能KV Cache调度与智能P2P互联,将KV Cache从HBM卸载至高性能AI SSD,构建HBM加DRAM加SSD三级存储体系,让有限显存承载无限上下文,使消费级硬件跑出企业级性能。杨泽宏在现场演示中给出数据:推理吞吐量从约120 token每秒跃升至610 token每秒,首Token延迟从27.99秒降至0.56秒——吞吐提升约5倍,响应速度提升约50倍。
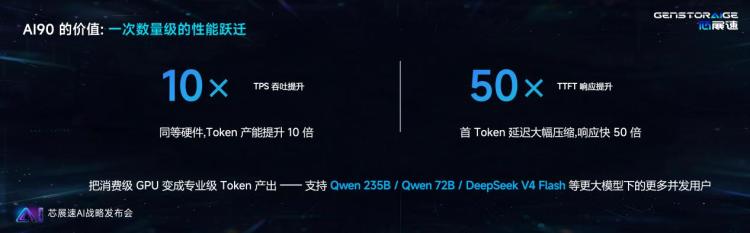 图:AI90 训推加速引擎 Token吞吐提升效果
端侧是三层布局的最后一环。芯展速战略合作伙伴Flowy CEO祁国良在演讲中分享了AI PC的技术实现:通过与芯展速AI30深度集成,将AI SSD引入端侧架构,配合端侧推理引擎Herdsman与混合模型策略,让AI PC可本地执行轻量任务、云端派发复杂推理,并实现Auto智能调度。祁国良表示,AI30让端侧设备真正成为独立的AI算力节点,端侧AI的“最后一公里”正在被铺平。
从云端的全介质统一存储,到边侧的Token工厂,再到端侧的Agent PC,三层产品各有侧重,却共享同一套存算协同的技术内核。这种分层落地的方式,使“以存强算”不再是一个抽象口号,而是在每一层都有可验证的产品与数据支撑。
三层协同的深层逻辑:为什么不能只做一层?
云、边、端三层同时推进,在产业界并不常见。外界关心的是,三层一起做,真正的好处究竟体现在哪里?对此,钱亚欧从三个层面进行了解释说明。
其一,数据链路天然是跨层的。AI的数据流端侧产生、边缘处理、云端训练,如果只优化单点,瓶颈不会在层内消失,只会转移到层与层之间,三层协同才能把“数据怎么跑通”真正跑通。其二,一套核心能力可以多层复用。贯穿三层的是同一套存算协同能力——智能P2P、KV Cache调度、高速链路的信号完整性,云端验证过的架构可以下沉到边端,边端的场景洞察又反哺云端的产品定义,研发成果在三层复利。其三,客户的负载本来就是跨层的。与一家能贯穿三层的厂商协同,可以做系统级优化,比如SSD和Retimer联合调优,从而降低导入成本和供应链风险。
 芯展速合伙人兼COO钱亚欧(右一)
钱亚欧强调,这三层并非平均用力,而是“云、边、端”渐进式推进,每一层都有清晰的里程碑产品:云端有PT200Z这样的AI SSD和Gen6 Retimer,边端侧有AI90存算协同方案。
反过来,只盯住一层会缺少什么?钱亚欧认为,缺的是链路视角。单层的性能只有在整条数据通路上才能兑现,只盯云就看不见端侧的显存墙和数据回流成本,只盯端又解决不了模型迭代、数据闭环和海量存储。他以具身智能为例说明:数据从端产生、到边缘处理、再到云端训练,这条链路不通,机器人就始终停留在试点几台,走不到规模上千台。此外,少了与相邻层联合调优的空间,性能天花板会低一截,客户侧的综合成本反而更高。
这一逻辑也解释了芯展速为何坚持“存、连、管”三位一体。存储解决数据的存放与访问,连接解决数据在链路中的高速传输,管理解决AI训推流程中的调度与优化——三者缺一,数据通路就会在某个环节出现断点。
云的未来与产业生态:分工调整而非此消彼长
随着模型越来越强、使用越来越频繁,云在AI中的角色是否会被边端削弱?钱亚欧明确表示,并不认同云和边端此消彼长的说法,“分工在调整,但不存在谁替代谁的问题”。他认为,模型能力在增强、推理成本在下降,越来越多的日常服务确实会在边端完成,但模型训练、海量数据的存放、知识的更新和迭代这些重活目前还是只能在云上做,短期内也看不到转移的可能。“因此未来三五年,云仍然是AI基础设施里承担最多的那一层,边端增长会很快,但更多是分流了原来集中在云上的部分请求,而不是取代云。”
被问及如果大部分日常智能服务不再往云端跑,云这一层是否会退到幕后时,钱亚欧则给出了否定的答案。在他看来,如果大量日常服务在本地就能完成,云会更像一个后方基地:模型在这里训练,数据在这里归档,全局的调度也在这里做。这里面有个朴素的逻辑——端侧的智能越普及,产生的数据越多,需要回到云端训练和沉淀的数据也越多,总量一直在涨。负载在云、边、端之间怎么分,最终要看时延、成本、隐私和能耗几个因素,不同行业的选择会不一样。但不管落在哪一层,数据都要存、要搬、要用得起来,存储和连接是绕不开的。
战略层面,芯展速正在通过生态合作将三层布局转化为产业闭环。在发布会压轴环节,钱亚欧代表芯展速先后与光环新网、海威智算、云工厂、Flowy签署战略合作协议,合作覆盖智算中心、云、端侧AI三大关键场景,宣告云边端生态闭环正式落地。
对于行业周期,钱亚欧保持着底线思维。他表示,存储是一个生态门槛极高的行业,芯展速还是一家年轻公司,需要向各个领先原厂看齐,和用户、生态一起配合打磨;周期的波动终会过去,但结构性的变革将重塑一切,芯展速押注的是数据持续增长这个确定性。
“用存储解决算力的瓶颈。”孙丹在发布会上的这句话,为整场活动定下注脚。当6万倍的算力增长遭遇线性的存储跟进,当智能体让数据7×24小时不息地流动,瓶颈的本质已从“算得不够快”转向“数据供不上”,而芯展速以存强算、云边端协同的路径,本质上是在回答一个更根本的问题:在AI时代,什么样的数据基座才能支撑智能的持续进化。答案或许不在某一层,而在层与层之间那条被打通的数据通路。(赵华)