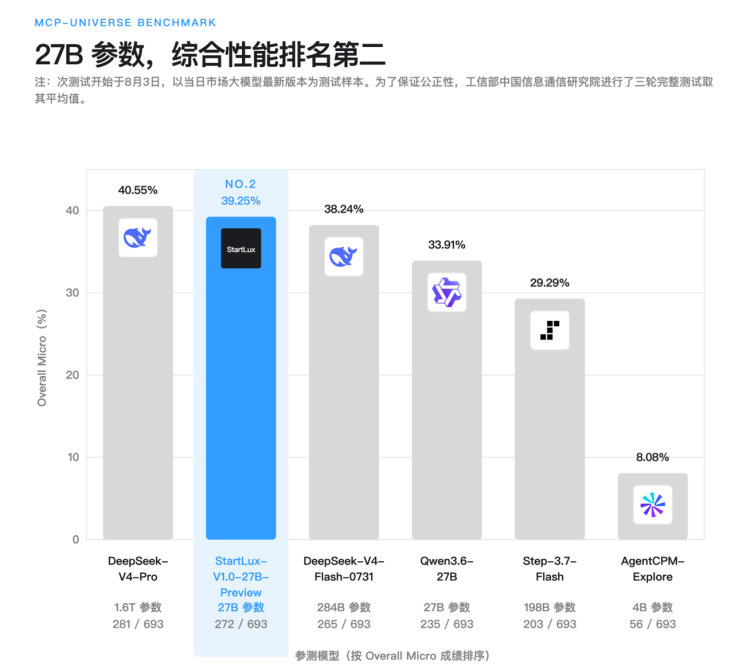
【环球网科技报道 记者 张阳】近日,中国信息通信研究院人工智能研究所发布的可信AI大模型MCP专项测试结果,在本就不平静的大模型行业激起了不小的波澜。上海原点星辉科学技术有限公司(下简称 StartLux)研发的StartLux-V1.0-27B-Preview本地大模型,仅凭27B的参数量便拿下综合性能第二的名次,不仅力压参数规模10倍于己的DeepSeek-V4-Flash,部分单项任务的表现更是追平了拥有1.6T参数的DeepSeek-V4-Pro。
在过去两年“参数至上”的行业氛围中,大家普遍信奉“大力出奇迹”的真理,参数越大,能力越强,万亿参数的云端旗舰是牌桌上的主角,参数越堆越大,榜单越刷越高。但企业用户和消费者真正头疼的问题是:模型能不能端侧运行?数据能不能不出域?成本能不能可控?所以一个消费级PC就能运行,还能效果不错的模型当然让业内震动。
参数差60倍的逆袭:打破参数决定论
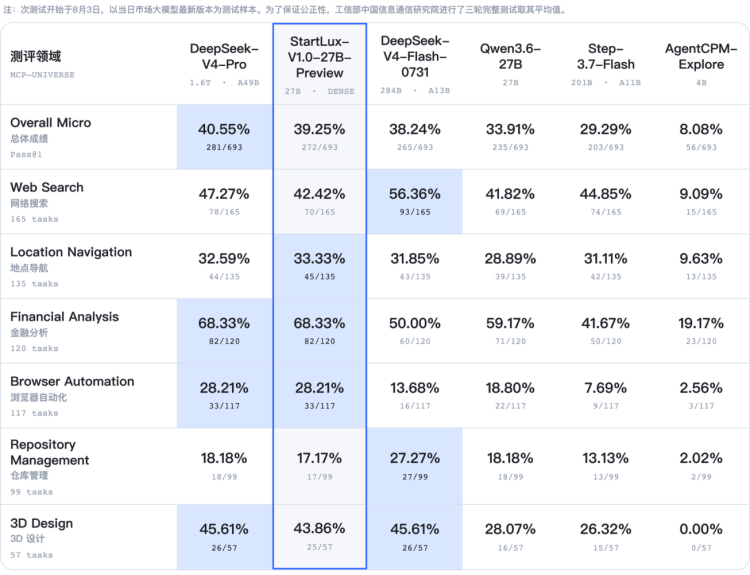
根据信通院发布的测试说明来看,本次MCP专项测试是当前国内针对大模型Agent能力的权威基准之一,重点考察模型在多工具协同、复杂任务执行及真实环境交互等方面的综合表现,涵盖位置导航、网页搜索、浏览器自动化、金融分析、代码仓库管理、3D设计6类专项任务及综合评估,共7项检验维度,部分指标参考了开源项目MCP-Universe。
参测阵容覆盖了不同参数级别的主流模型:既有1.6T参数的DeepSeek-V4-Pro、284B参数的DeepSeek-V4-Flash-0731、198B参数的Step-3.7-Flash等云端大模型,也包括StartLux-27B、Qwen-3.6-27B两款27B参数模型,以及4B参数的AgentCPM-Explore。
最终的测试结果打破了很多人的固有认知:StartLux-27B以39.25%的综合得分位列第二,比排名第三的DeepSeek-V4-Flash高出1个百分点,而后者的参数规模是前者的10倍以上。在同参数量级的对比中,StartLux-27B较Qwen-3.6-27B高出5.34个百分点,优势十分显著。
单项任务的表现更具说服力:在位置导航任务中,StartLux-27B登顶第一;在金融分析、浏览器自动化等任务上,它与1.6T参数的DeepSeek-V4-Pro不相上下,部分指标并列第一。两者参数规模相差近60倍,综合得分差距却仅1.3个百分点,这一结果直接动摇了“参数规模决定能力上限”的行业共识。
“能跑”≠“能用”:本地模型需要跨过实用门槛
近几年,端侧大模型一直是行业热门方向,手机、PC、边缘设备纷纷宣布支持本地运行大模型。但绝大多数小参数模型只能完成问答、摘要等基础任务,一旦涉及多工具调用、长流程处理等复杂Agent场景,能力便会大幅跳水,始终停留在“演示级”,无法真正投入生产使用。
这正是StartLux-27B引发行业震动的根本原因:它没有走“牺牲能力换体积”的老路,而是在27B的参数规模下,将多工具协同与复杂任务处理能力拉到了接近云端旗舰模型的水平。简单来说,此前的本地模型是“能跑”,而这款模型第一次做到了“能干活”。
一旦跨过了这道门槛,本地模型的吸引力就凸显了,数据留在自己机器上,推理成本就是电费和硬件折旧,服务不依赖外部网络,性价比优势会迅速显现。
支撑这一突破的,是团队自主设计的多维度模型优化升级技术。据了解,StartLux以Qwen3.6-27B为基座,采用“AI训练AI”的Auto Research方法开展后训练定向增强,通过自主实验与反馈闭环持续优化训练策略,针对真实场景下的工具调用与任务执行能力做了深度适配。这也是国内首个采用该技术路径完成后训练的本地Agent模型。
本地模型的牌局,刚刚开始
全球范围内,本地模型已经不是边缘话题。Google在4月推出Gemma4系列,其中31B Dense版本在开源模型排行榜排名第三,量化后可在消费级显卡上运行。Meta在8月初发布30B本地模型MuseGlimmer并开源。NVIDIA也在8月推出Nemotron3.5Lightning,30B参数的MoE模型,可直接在RTX PC等本地设备上运行。
原点星辉StartLux创始人兼CEO陈大年预测,本地模型将在3年内占据80%的大模型市场。
StartLux-27B引起关注,核心不是它“打败”了DeepSeek-V4-Flash。而是一个27B的本地模型,在Agent任务上达到了可用的稳定状态。它验证了一条高性价比的落地路径:不需要盲目追求万亿参数,通过精准的后训练定向优化,中小参数模型同样可以在核心场景下达到旗舰级能力,并且能够在消费级设备上稳定运行。
当然,现在就说本地模型要颠覆云端,还太早。StartLux-27B目前是Preview版本,在通用知识、长文本、多模态上,和万亿旗舰的差距依然存在。MCP测试只覆盖六类场景,真实工作远比这复杂,量化后的显存要求、推理速度、并发能力都还需要产品来检验。
可以预见,未来的大模型市场不会是云端模型的独角戏,而是会形成“云端+本地”的分层协同格局:云端超大规模模型负责处理高度复杂的通用任务,而大量日常办公、企业生产、边缘设备等场景,将由部署更灵活、数据更安全、成本更可控的本地大模型承接。随着更多玩家深耕场景、打磨实用能力,大模型真正走进每一台设备、解决每一个具体问题的时代,或许比我们预想的来得更快。