【环球网科技综合报道】9月22日,在2026杭州云栖大会企业级Agent实践峰会上,基元律动联合创始人兼CTO韩凯发表演讲《从Harness到RSI飞轮》。他认为,多模型长期异构并存、算力资源多元供给,将成为大模型产业的长期结构。随着Agent承担越来越复杂的任务,如何组织不同模型,并将应用中的反馈转化为模型改进的依据,正在成为新的技术课题。
据国家数据局披露,2026年3月,我国日均Token调用量已超过140万亿,较2024年初增长超千倍。韩凯在分享中指出,一次复杂Agent任务往往涉及十余次乃至数十次模型调用。任务表现既取决于模型本身,也取决于支撑任务执行的系统能力,包括模型选择、工具调用与上下文管理等。
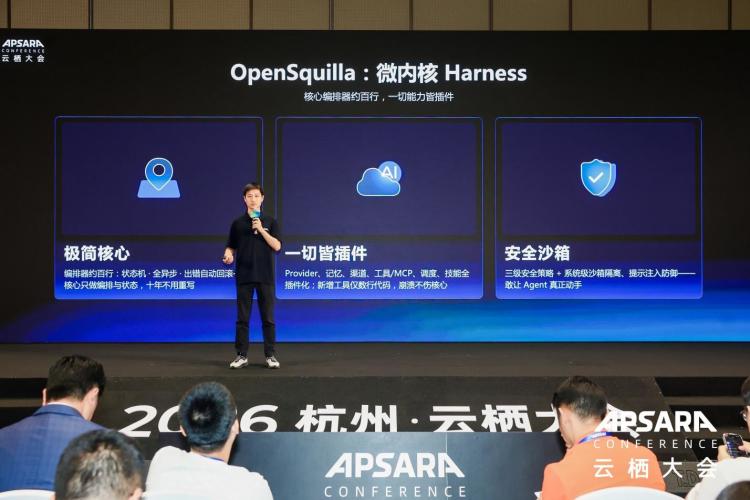
Harness是支撑Agent执行任务的运行框架,模型路由是其中的一项关键能力。在韩凯看来,不同模型在能力、成本和响应速度上各有特点,复杂任务需要根据每一步的需求选择合适的模型。模型异构适配与算力异构调度,也需要相应的专业能力支撑。
基元律动以开源项目OpenSquilla探索这一方向。据公司公布的端到端Agent评测结果,在特定测试配置下,OpenSquilla保留了固定旗舰模型基线99.96%的任务质量,同时将成本降低88.9%。在另一组DRACO深度研究评测中,多模型协同配置的得分超过该组实验中的最强单模型基线,成本约为其三分之一。这些结果展示了模型调度在特定任务中的成本与效果优势。
“路由层的价值,在于让每一步任务用对模型、用得起模型。”韩凯说。
在模型调度之外,韩凯进一步介绍了面向RSI(递归式自我改进)的反馈闭环:以场景中的能力需求为牵引,通过评测识别模型与调度策略的改进方向,开展针对性优化,再将升级后的能力应用于场景中验证效果。这一机制将模型应用、能力评测与后续迭代连接起来,探索Agent在持续验证与优化中提升任务表现的路径。
9月发布的NeoHorse-1是这一路径的初步验证。该系列模型基于通义Qwen3.5底座完成后训练。根据其初版技术报告,在十项基准评测中,4B版本的宏平均得分由58.94提升至64.87,9B版本由65.60提升至69.04。其中,4B后训练版本在VitaBench、τ²-Bench、PinchBench、QwenClawBench和HumanEval五项评测中超过Qwen3.5-9B底座模型,整体平均得分也进一步接近9B底座。这一结果初步展示了利用Agent运行经验改进模型的可行性。
在合作层面,据韩凯介绍,基元律动与阿里云围绕Qwen系列开展场景测试、评测和应用验证,在自身Harness与Agent产品中持续使用模型、积累反馈,并推动新版本接入TokenRhythm路由平台。同时,基础设施方面,阿里云为相关业务运行提供云服务支持,无问芯穹为NeoHorse-1的训练与推理提供算力支持及基础设施优化。
从Harness到RSI,基元律动希望将模型调度与模型迭代连接起来,一方面,让已有模型在合适的任务中发挥能力;另一方面,让任务执行过程中积累的经验进入后续训练与评测,逐步探索Agent持续进化的路径。(古雨)